










Aktualności
Europejskie technologie w obronie i przestrzeni kosmicznej
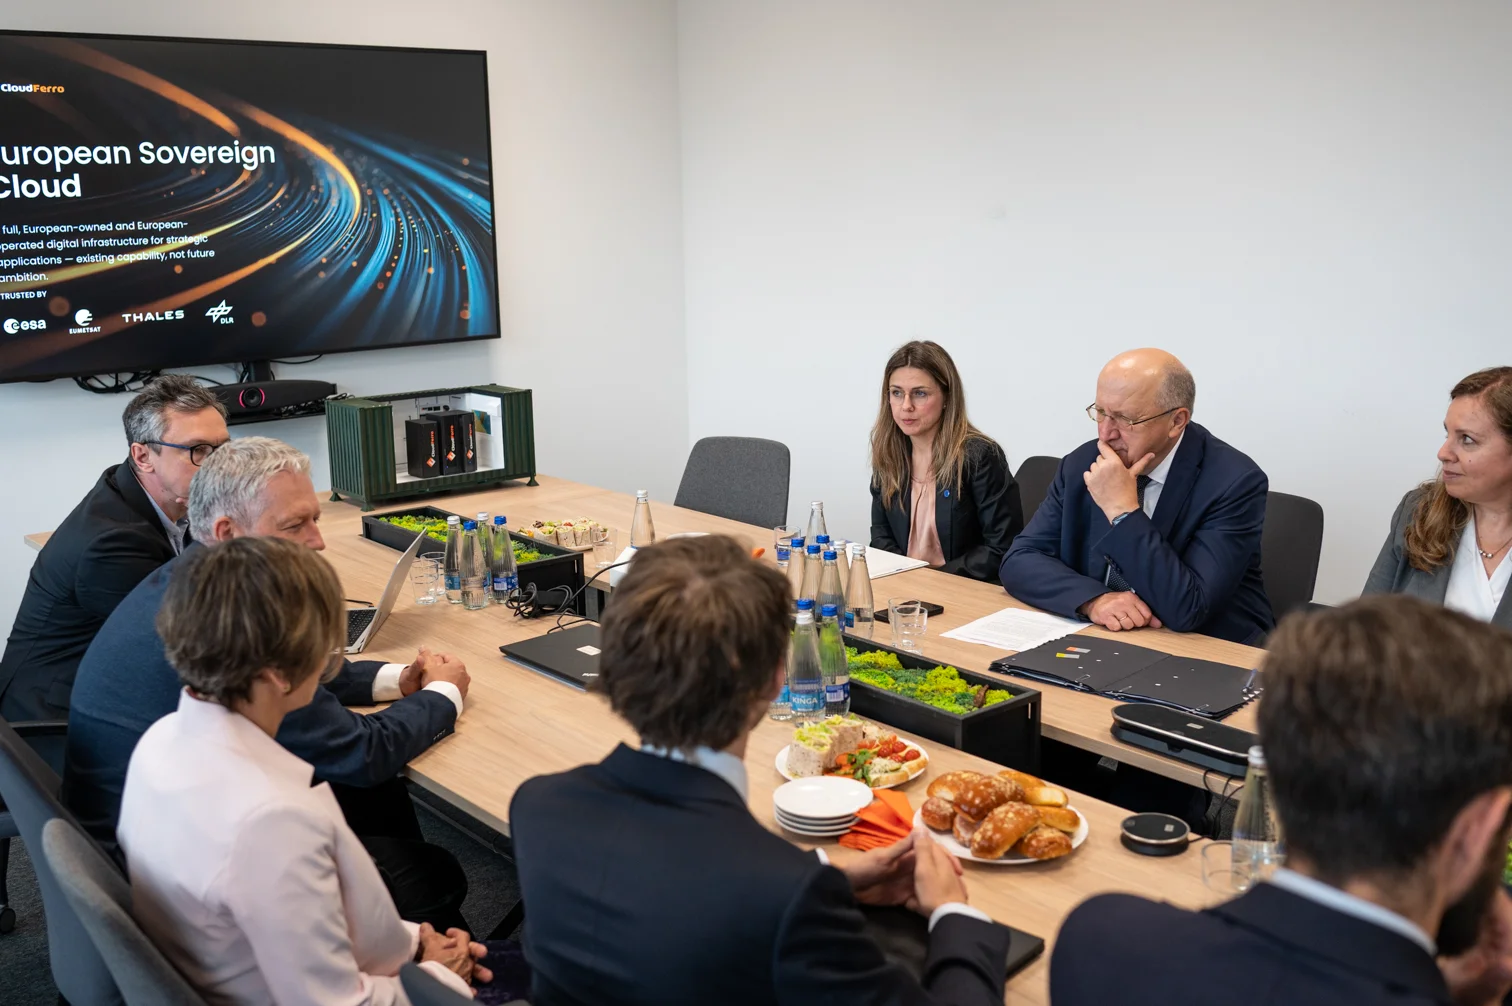
Wizyta komisarza Andriusa Kubiliusa w CloudFerro potwierdza znaczenie europejskich technologii dla bezpieczeństwa i gotowości operacyjnej Europy.
Aktualności
Wizyta komisarza Andriusa Kubiliusa w CloudFerro potwierdza znaczenie europejskich technologii dla bezpieczeństwa i gotowości operacyjnej Europy.
Aktualności
CloudFerro udostępniło w Sherlocku nową funkcjonalność Search Agents & Knowledgebases, która ułatwia budowę agentów AI odpowiadających na pytania na podstawie własnych dokumentów organizacji.
Chmura publiczna · Compute
Zasoby GPU dostępne na żądanie w centrach danych w UE, od akceleracji klasy RTX po klastry H200 z maksymalnie 32 GPU. Zaprojektowane z myślą o zadaniach AI, ML, HPC i renderingu, zintegrowane z siecią i storage'em w chmurze.
Funkcje produktu
CloudFerro GPU Services zapewnia natychmiastowy dostęp do nowoczesnych procesorów NVIDIA GPU w trzech modelach udostępniania.
RTX A6000, RTX PRO 6000 Blackwell, L40S, A100, H100 i H200, dostępne jako współdzielone maszyny wirtualne vGPU, dedykowane instancje z PCI passthrough oraz standardowe wielowęzłowe klastry H200. Dostępność zależy od regionu i modelu udostępniania.
Współdzielone maszyny wirtualne vGPU do szybkiego eksperymentowania i optymalizacji kosztów; dedykowane instancje z PCI passthrough zapewniające przewidywalną wydajność zbliżoną do natywnej; standardowe wielowęzłowe klastry H200 z maksymalnie 32 GPU do treningu rozproszonego i zadań HPC.
Lokalna przestrzeń NVMe scratch tam, gdzie jest dostępna, oraz w pełni zintegrowany Block Storage i Object Storage do stagingu zbiorów danych, checkpointingu i wydajnego dostępu do danych w całym pipeline AI i HPC.
Uruchamiaj zasoby GPU, zarządzaj nimi i automatyzuj je za pośrednictwem portalu CloudFerro lub REST API. Usługa wspiera procesy IaC i narzędzia automatyzacji, umożliwiając powtarzalne i skalowalne wdrożenia.
Nasze maszyny wirtualne GPU zapewniają wysoką wydajność w wymagających zadaniach, takich jak trenowanie dużych modeli AI, inferencja na dużą skalę czy przetwarzanie obszernych zbiorów danych.
Skracaj czas trenowania modeli z tygodni do godzin. Skaluj trening na wiele GPU, aby jeszcze szybciej uzyskiwać wyniki.
Płać tylko za wykorzystane zasoby dzięki rozliczeniu godzinowemu. Bez inwestycji w sprzęt z góry i bez kosztów jego utrzymania.
Korzystaj z całodobowego wsparcia technicznego z gwarantowanym SLA. Klienci enterprise mogą również liczyć na dedykowanych opiekunów.
Przetwarzaj dane obserwacji Ziemi na GPU znajdujących się w tym samym centrum danych. Ograniczaj wąskie gardła związane z transferem danych.
zastosowania
INTEGRACJE
Instancje GPU integrują się ze storage'em, siecią i zarządzanymi usługami AI CloudFerro, umożliwiając budowę kompletnych pipeline'ów AI i HPC bez przenoszenia danych poza UE.
Podłączaj trwałe wolumeny SSD do instancji GPU, aby zapewnić wydajny dostęp do danych, checkpointing modeli i przechowywanie wyników. Dane pozostają dostępne niezależnie od cyklu życia instancji.
Przygotowuj duże zbiory treningowe i przechowuj artefakty modeli w Object Storage zgodnym z S3, dostępnym bezpośrednio z instancji GPU w tym samym suwerennym środowisku.
Pełne możliwości sieciowe OpenStack: sieci prywatne, routery, floating IP i security groups, które umożliwiają izolację zadań GPU oraz bezpieczną pracę w środowisku wielodostępnym.
Uzupełnij zasoby GPU o zarządzaną inferencję GenAI CloudFerro. Połącz dedykowaną infrastrukturę treningową z API LLM zaprojektowanym z myślą o prywatności, aby budować kompletne pipeline'y AI.
Uruchamiaj zasoby GPU i zarządzaj nimi przez REST API lub szablony orkiestracji OpenStack Heat. Pełna zgodność z Terraform, Ansible i popularnymi narzędziami automatyzacji AI/HPC.
Zgodność z TensorFlow, PyTorch, CUDA, RAPIDS oraz innymi popularnymi frameworkami ML i HPC, które możesz wdrażać na żądanie ze standardowym wsparciem sterowników NVIDIA dla wszystkich modeli GPU.
zakres usługi
Zasoby obliczeniowe akcelerowane przez GPU w centrach danych w UE, dostępne jako współdzielone maszyny wirtualne vGPU, dedykowane instancje z PCI passthrough oraz standardowe klastry H200 — zintegrowane z siecią i storage'em CloudFerro do budowy kompletnych pipeline'ów AI i HPC.
RTX A6000 · RTX PRO 6000 Blackwell · L40S · A100 · H100 · H200 (dostępność zależy od regionu i modelu)
Współdzielone maszyny wirtualne vGPU · Dedykowane PCI passthrough · Standardowe klastry H200 z maksymalnie 32 GPU
Lokalna przestrzeń NVMe scratch (tam, gdzie jest dostępna) · Zintegrowany Block Storage i Object Storage
Samoobsługowo przez portal i REST API · Zgodność z IaC / automatyzacją
Pełne możliwości OpenStack · Sieci prywatne · Security groups · Floating IP
Rozliczenie według wykorzystania oraz indywidualne warunki · Tabele cenowe dostępne dla poszczególnych regionów chmurowych
FAQ
Nie znalazłeś odpowiedzi? Skontaktuj się z nami, jeśli potrzebujesz dodatkowych informacji lub chcesz porozmawiać z naszym zespołem.
Moc obliczeniowa
Uruchamiaj mniej krytyczne, odporne na przerwy zadania na ekonomicznych maszynach wirtualnych OpenStack w europejskich centrach danych.
Storage
Twórz i zarządzaj trwałymi wolumenami Block Storage, kopiami zapasowymi, migawkami oraz grupami wolumenów.
Storage
Zarządzaj kontenerami i bucketami Object Storage, korzystając z dostępu do danych zgodnego z S3 i Swift.
AI i Machine Learning
Orkiestruj przetwarzanie danych, trening, ewaluację, wdrażanie i ponowne trenowanie modeli w procesach opartych na kontenerach i Kubernetes. Korzystaj z rozproszonego treningu CPU/GPU oraz śledzenia artefaktów.
AI i Machine Learning
Korzystaj z w pełni zarządzanej usługi GenAI, która zapewnia wysoki poziom prywatności, zgodność z API OpenAI oraz przetwarzanie danych w Polsce, w całości na europejskiej infrastrukturze.
Bazy danych
Zarządzane instancje PostgreSQL, MySQL, MariaDB, Valkey i MS SQL Server z automatycznymi kopiami zapasowymi, failover i monitoringiem.